ubuntu sqlserver 解决中文乱码问题

浪淘沙2年前数据库562

1、检查系统本地化设置

locale

如果发现 LANG 或 LC_ALL 不是中文,如 zh_CN.UTF-8,需要设置正确的本地化。

2、设置系统本地化为中文

编辑 /etc/default/locale 文件,添加以下行

LANG="zh_CN.UTF-8"
LANGUAGE="zh_CN:zh"

3、如果数据库的Collocation是英文的,字段是varchar类型,向表中插入中文数据,会出现乱码

f71e8d9bd38252f2bd8d561cd9c62f21.png

CREATE DATABASE MyDBTest(库名) COLLATE Chinese_PRC_CI_AS_WS
或
alter database MyDBTest(库名)  collate Chinese_PRC_CI_AS

参数解释如下:

前半部份:指UNICODE字符集,Chinese_PRC_指针对大陆简体字UNICODE的排序规则。

排序规则的后半部份即后缀 含义:

  _BIN 二进制排序

  _CI(CS) 是否区分大小写,CI不区分,CS区分

  _AI(AS) 是否区分重音,AI不区分,AS区分   

  _KI(KS) 是否区分假名类型,KI不区分,KS区分 

        _WI(WS) 是否区分宽度WI不区分,WS区分 

区分大小写:如果想让比较将大写字母和小写字母视为不等,请选择该选项。

区分重音:如果想让重音和非重音字母视为不等,请选择该选项。如果选择该选项,

比较还将重音不同的字母视为不等。

区分假名:如果想让比较将片假名和平假名日语音节视为不等,请选择该选项。

区分宽度:如果想让比较将半角字符和全角字符视为不等,请选择该选项

相关文章

ERROR: duplicate key value violates unique constraint "pub_menu_pkey" DETAIL: Key (id)=(1) already

CREATE SEQUENCE rw_fl_id_seq START 1;重新生成序列:如果是自动递增字段,可能需要重置序列,特别是在删除记录之后。例如,执行以...

给表加备注

EXEC sys.sp_addextendedproperty @name=N'MS_Description',@level1type=N'TABLE...

sqlserver 删除数据,并且序号恢复从1开始

delete from article_author;dbcc checkident('article_author',reseed,0)...

postgresql 怎么设置用户,拒绝连上其它库

1、用 超级用户(postgres)执行:SELECT datname,        has_database_pr...

sqlite安装及创建数据库

sqlite安装及创建数据库

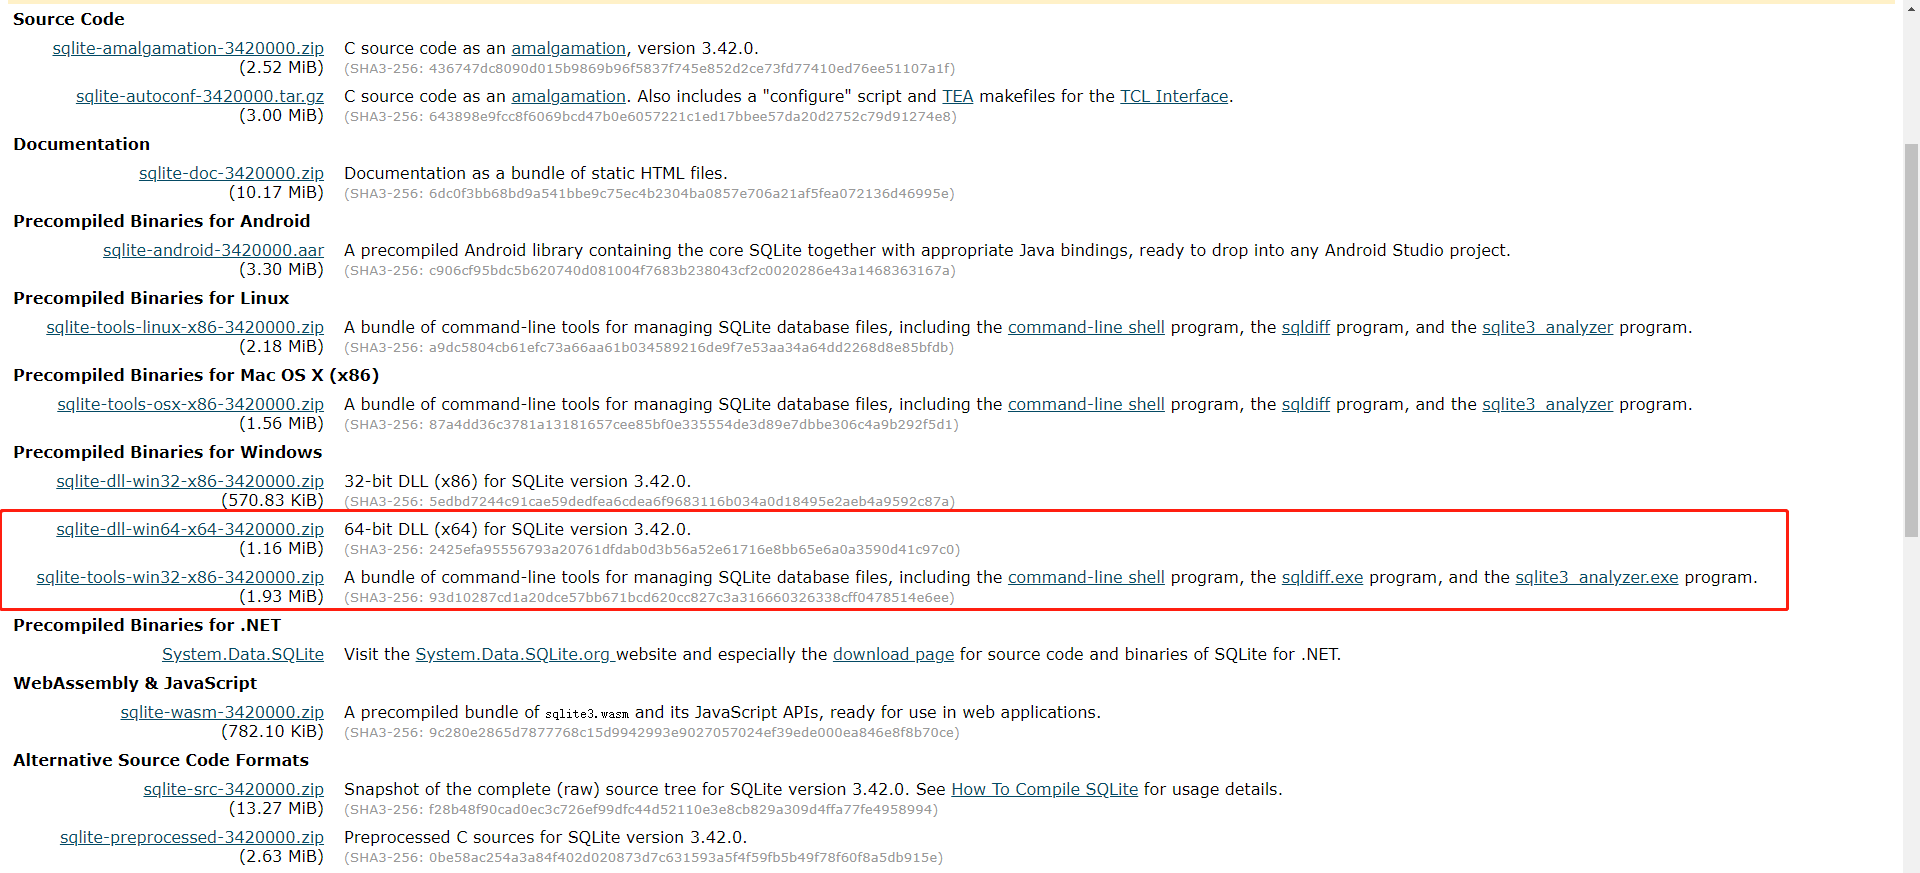
首先进入Sqlite官方网址:https://www.sqlite.org/download.html然后下载下面框起来的两个压缩文件 下载完成后解压接下来去配置环境变量,右键此电脑->...

Ubuntu 22.04 安装linux sqlserver

1、下载公钥,从 ASCII 转换为 GPG 格式,并将其写入所需的位置:curl -fsSL https://packages.microsoft.com/keys/micros...

发表评论    

◎欢迎参与讨论,请在这里发表您的看法、交流您的观点。